Auf dieser Seite
Wenn KI-Memory nicht zwischen Tools mitwandert
 Ammar Najjar
 KI-generiertes Bild
Ich nutze regelmäßig verschiedene KI-Tools, die jeweils unterschiedliche Aufgaben übernehmen. ChatGPT hilft mir dabei, Ideen zu entwickeln, Artikel zu schreiben, Texte zu überarbeiten und Erfahrungen zu reflektieren. Claude Code unterstützt mich bei einem großen Teil meiner technischen Arbeit, von der Untersuchung konkreter Probleme über die Planung von Implementierungen bis hin zur Bewertung von Architekturentscheidungen. Daneben nutze ich lokale KI-Modelle für persönliche Inhalte, die ich lieber auf meinem eigenen Rechner verarbeite.
Als diese Tools zunehmend Teil meines Arbeitsalltags wurden, fiel mir eine Einschränkung auf. Jedes konnte im Laufe der Zeit bestimmte Aspekte meiner Arbeit, meiner Vorlieben und früherer Gespräche kennenlernen. Dieses Wissen blieb jedoch weitgehend auf das jeweilige Tool beschränkt. So konnte ich mich mit einem Assistenten ausführlich mit einem Thema beschäftigen und musste einem anderen später denselben Hintergrund erneut erklären.
Eine ähnliche Herausforderung kannte ich bereits aus der Arbeit mit meinem Obsidian-Vault, der inzwischen auf mehr als 1.000 Notizen angewachsen war. In Wissen langfristig nutzbar halten habe ich beschrieben, wie die Organisation und das Wiederfinden von Informationen darüber entscheiden, ob dieses Wissen langfristig nützlich bleibt. Diese Erfahrung beeinflusste auch meinen Blick auf das Wissen, das sich in meinen verschiedenen KI-Tools ansammelte.
Was man von KI-Memory erwarten kann
Meine Erwartungen an KI-Memory haben sich vor allem durch die praktische Nutzung entwickelt. Wenn ich zu einem Thema zurückkehre, möchte ich, dass der Assistent den relevanten Hintergrund kennt, bereits festgelegte Präferenzen berücksichtigt und frühere Entscheidungen oder Beobachtungen in die neue Unterhaltung einbezieht.
Mit der Zeit wurde mir klar, dass verschiedene Mechanismen zu dem beitragen, was wir als Erinnerung wahrnehmen. Der Chatverlauf bewahrt frühere Gespräche auf, deren Inhalte jedoch nicht zwangsläufig in einer neuen Sitzung verfügbar sind. Eine persistente Memory-Funktion kann ausgewählte Informationen über mehrere Gespräche hinweg behalten, während der aktuelle Kontext bestimmt, welche Informationen das Modell während einer Unterhaltung tatsächlich nutzen kann. Bei technischen Tools kommen häufig Projektdateien, Anweisungen und Dokumentationen hinzu, die Informationen zwischen Sitzungen erhalten.
Wie lange Informationen relevant bleiben, hängt von ihrer Art ab. Meine Schreibpräferenzen können über Monate hinweg nützlich sein, während sich Implementierungsdetails häufig ändern. Eine Architekturentscheidung kann für die gesamte Laufzeit eines Projekts wichtig bleiben, während eine persönliche Beobachtung vielleicht erst dann wieder Bedeutung gewinnt, wenn ich eine ähnliche Situation erlebe.
Unterschiedliche Tools, unterschiedliches Wissen
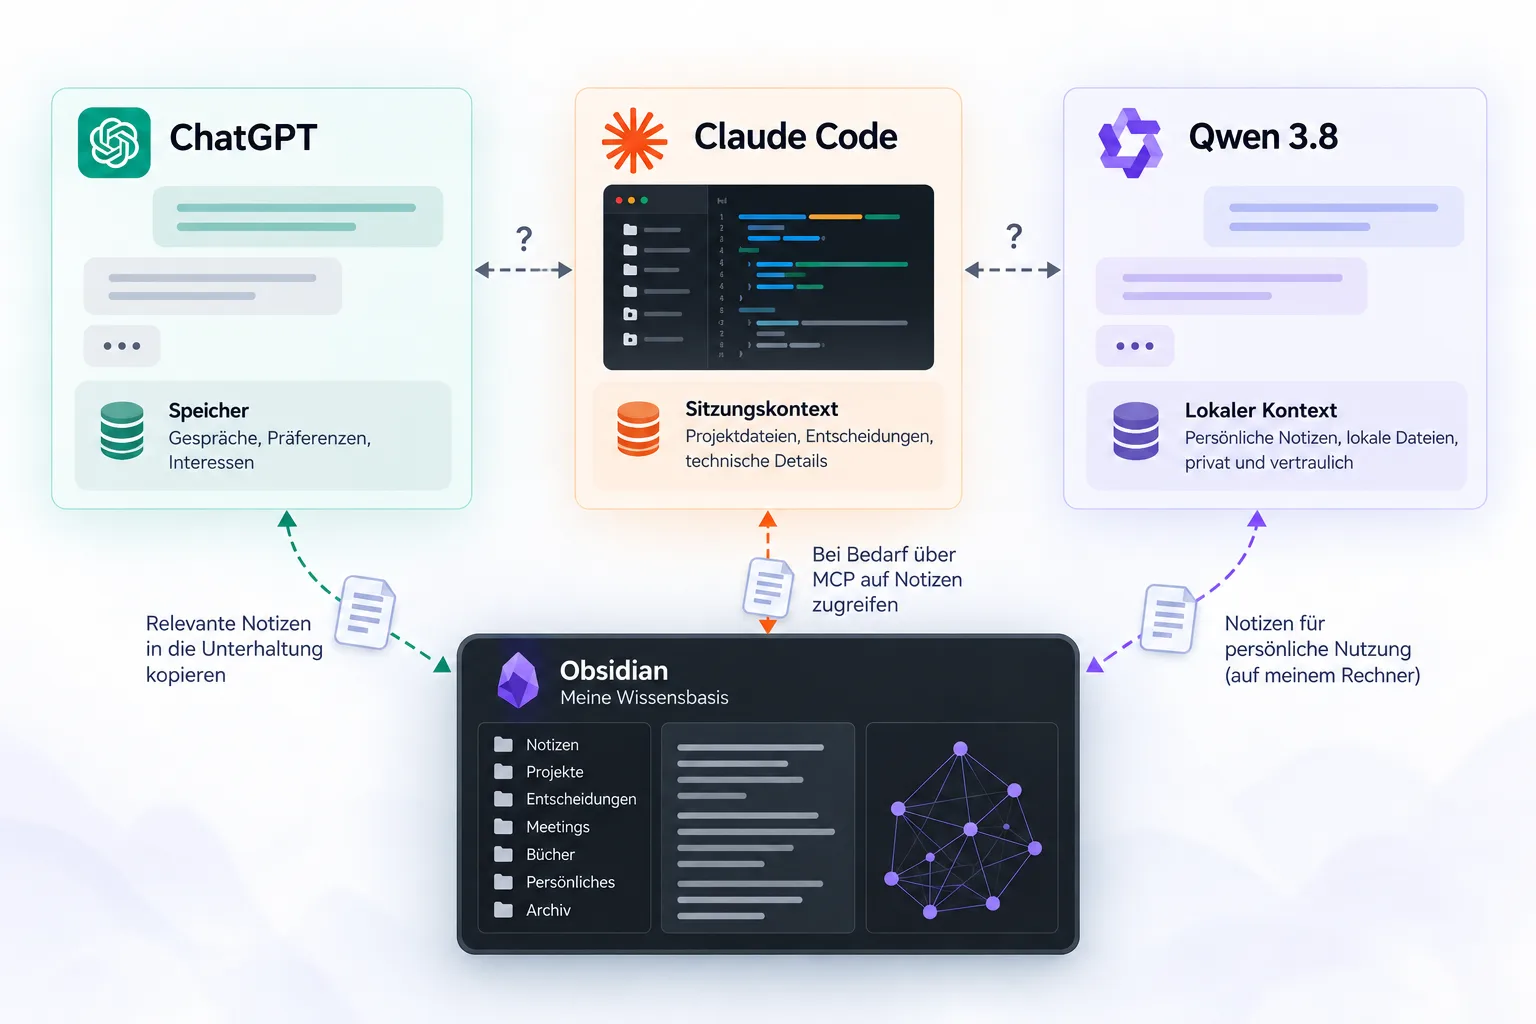
ChatGPT hat durch unsere Gespräche einiges über meinen beruflichen Hintergrund und meine Interessen erfahren. Claude Code entwickelt ein anderes Verständnis, während es mit Repositories arbeitet, technische Probleme untersucht und Implementierungsentscheidungen begleitet.
Meine lokalen Modelle greifen dagegen auf den Kontext und die Dateien zurück, die ich ihnen zur Verfügung stelle. Ich nutze sie für die meisten persönlichen Aufgaben, etwa um Erfahrungen zu reflektieren, Familien- und Haushaltsangelegenheiten zu planen, Gesundheit und Gewohnheiten zu dokumentieren, persönlichen Interessen nachzugehen oder vertrauliche Dokumente zu verarbeiten, die auf meinem Rechner bleiben sollen. Dieses lokale Setup beschreibe ich ausführlicher in Mein lokales KI-Setup, sechs Monate später.
Diese Aufteilung passt zu meiner Arbeitsweise, und ich schätze die Spezialisierung der einzelnen Tools. Allerdings lassen sich Themen nicht immer so klar voneinander trennen. Eine Architekturdiskussion kann später für die Implementierung relevant werden, und eine technische Erfahrung kann die Grundlage für einen Artikel oder eine Reflexion über Führung bilden.
Wenn ein Thema von einem Tool zum anderen wechselt, steht das zuvor erarbeitete Wissen dort nicht automatisch zur Verfügung. Ich muss selbst erkennen, welche Informationen relevant sind, und sie in die nächste Unterhaltung einbringen.
Wo KI-Memory mir geholfen hat
Ein hilfreiches Beispiel ist die Möglichkeit, ChatGPT nach früheren Gesprächen zu einem bestimmten Thema zu fragen. Wenn ich eine Idee über mehrere Unterhaltungen hinweg entwickelt habe, kann ich mir manchmal die damaligen Beobachtungen, Entscheidungen und Schlussfolgerungen zusammenfassen lassen. So habe ich einen brauchbaren Ausgangspunkt, um daran weiterzuarbeiten.
Ein weiterer Anwendungsfall sind Empfehlungen, die auf meinem persönlichen Profil basieren. ChatGPT kann häufig meinen beruflichen Hintergrund, meine Verantwortlichkeiten und Interessen berücksichtigen. Dadurch passen die Antworten besser zu meiner Situation, ohne dass ich die gesamten Umstände jedes Mal neu erklären muss.
Diese Erfahrungen haben mir gezeigt, wie hilfreich gespeicherte Informationen sein können. Am zuverlässigsten funktionierte das für mich, wenn ich ChatGPT ausdrücklich aufforderte, frühere Informationen einzubeziehen, insbesondere wenn ich selbst bereits wusste, welcher Hintergrund relevant war. Für gezielte Recherchen und Reflexionen war das nützlich. Weniger vorhersehbar war es, wenn ich erwartete, dass wichtige Informationen auch ohne ausdrückliche Aufforderung in eine neue Unterhaltung einfließen.
Wo KI-Memory nicht funktioniert hat
Die Unzuverlässigkeit zeigte sich am deutlichsten in zwei Situationen: wenn ich nicht nach vorherigem Kontext fragte und wenn der relevante Kontext in einer Unterhaltung statt in einer separaten Datei stand.
Ohne explizite Aufforderung könnte ChatGPT meine allgemeine berufliche Situation berücksichtigen, dabei aber Details aus früheren Diskussionen übersehen, die die Formulierung einer Empfehlung verändert hätten. Die Antwort könnte trotzdem nützlich sein, erforderte dann aber zusätzliche Klärung. Vorauszusagen, welche früheren Gespräche relevant sein könnten, ist unmöglich, und es gibt keine Möglichkeit zu prüfen, was der Assistent in seinem Speicher gespeichert hat.
Claude Code stellt eine ähnliche Schwierigkeit in einem anderen Kontext dar. Während einer umfangreichen technischen Aufgabe verlasse ich mich auf Untersuchung und Diskussion, um wichtigen Kontext zu entwickeln. Rahmenbedingungen werden festgelegt, Alternativen bewertet, Entscheidungen getroffen, und ein Verständnis des Problems entwickelt sich schrittweise.
Ein Teil dieser Informationen wird Teil des Codes oder der Dokumentation. Andere Details verbleiben im Gespräch, insbesondere die Begründung hinter Entscheidungen und die betrachteten Alternativen. Das Starten einer neuen Sitzung ohne Wiederherstellung des relevanten Kontexts bedeutet, dass ich Teile dieser Begründung rekonstruieren muss. Claude Code bietet Möglichkeiten, Sitzungen fortzusetzen und Projektanweisungen zu pflegen, aber der Arbeitsablauf stellt die benötigten Informationen nicht immer zum richtigen Zeitpunkt bereit.
Die Fehlfunktion liegt nicht an den Tools. Es ist meine Verantwortung, zu erkennen, welche Informationen relevant sind, sie auszuwählen und verfügbar zu machen. Das funktioniert, wenn eine Aufgabe eng gefasst ist und die relevanten Materialien offensichtlich sind. Es funktioniert nicht, wenn die Unterhaltung mehrere Themen abdeckt, oder wenn das Gesuchte vor Wochen diskutiert und nie außerhalb des Chats gespeichert wurde.
Obsidian als gemeinsame Wissensquelle
In Obsidian hatte ich bereits eine umfangreiche Sammlung von Notizen zu technischem Wissen, Entscheidungen, Besprechungen, Büchern und Erfahrungen aus meinem Berufsalltag aufgebaut. Da viele dieser Informationen bereits strukturiert und miteinander verknüpft waren, lag es nahe, sie auch meinen KI-Tools als Kontext zur Verfügung zu stellen.
 KI-generiertes Bild
Bei ChatGPT wählte ich dafür passende Notizen aus Obsidian aus und kopierte ihren Inhalt in die Unterhaltung. So konnte ich gezielt Hintergrundinformationen bereitstellen, beispielsweise wenn ich eine frühere Entscheidung erneut betrachten, eine Idee aus einem Buch weiterentwickeln oder über eine zurückliegende Erfahrung nachdenken wollte.
Mit Claude Code nutzte ich eine Obsidian-Integration über MCP, mit der der Agent Notizen lesen und aktualisieren konnte. Statt Inhalte selbst zu kopieren, konnte ich Claude Code bitten, eine bestimmte Notiz abzurufen oder das Ergebnis einer Diskussion festzuhalten. In der Praxis verwies ich Claude Code gezielt auf einzelne Notizen, anstatt es den gesamten Vault durchsuchen zu lassen.
Beide Ansätze waren hilfreich. Ich konnte dieselbe Wissensbasis in unterschiedlichen Umgebungen nutzen und behielt die Kontrolle darüber, welche Informationen ich weitergab. Das war besonders wichtig, wenn persönliche Hintergründe für eine Aufgabe relevant waren und ich selbst entscheiden wollte, welche davon durch ein gehostetes Modell verarbeitet werden durften. Diese Trennung beeinflusste auch meinen Umgang mit Obsidian. Manche Notizen konnte ich für die Arbeit mit gehosteten Assistenten verwenden, während andere ausschließlich in meiner lokalen Umgebung bleiben sollten.
Allerdings musste ich weiterhin selbst erkennen, welche Notizen für eine Aufgabe hilfreich sein könnten, und dafür sorgen, dass der jeweilige Assistent Zugriff auf sie bekam. Wenn aus einer Unterhaltung eine wichtige Beobachtung oder Entscheidung hervorging, musste ich außerdem daran denken, sie festzuhalten. Claude Code konnte zwar direkt mit dem Vault arbeiten, erkannte dadurch aber nicht automatisch, welche Informationen abgerufen oder gespeichert werden sollten.
Solange ich diese Schritte bewusst ausführte, funktionierte der manuelle Ansatz. Mit zunehmender Zahl an Gesprächen und Themen wurde es jedoch schwieriger, ihn konsequent beizubehalten. Ich schätzte die Kontrolle darüber, auf welche Informationen die einzelnen Assistenten zugreifen konnten. Gleichzeitig wollte ich weniger Zeit damit verbringen, diesen Austausch zu organisieren, und mich stärker auf die eigentliche Arbeit konzentrieren. Genau diese Schwierigkeit wollte ich in der nächsten Ausbaustufe abbauen.
Was verbessert werden muss
Das Problem sind nicht die Tools selbst, sondern die Art und Weise, wie sich Informationen auf sie verteilen. Jedes Tool entwickelt sein eigenes Memory, aber es gibt keinen gemeinsamen Ort, um das Wissen zu speichern, das ich zwischen ihnen bewegen kann. Ich muss Notizen manuell auswählen, in Unterhaltungen kopieren und einfügen, oder Claude Code auf bereits identifizierte Dateien verweisen.
Zwei Dinge müssen sich ändern. Erstens ein System, das relevante Informationen zuverlässiger abrufen kann, ohne dass ich vorher wissen muss, welche Notizen relevant sind. Zweitens die Reduzierung des manuellen Aufwands beim Übertragen von Kontext zwischen Tools, bei gleichzeitiger klarer Kontrolle darüber, auf welchen Assistenten welche Informationen zugreifen.
An welchen Stellen geht euch beim Wechsel zwischen KI-Tools am häufigsten Kontext verloren, und wie viel davon würdet ihr automatisch verwalten lassen?
Mich würde interessieren, wie ihr dabei zwischen Komfort und Kontrolle abwägt.