في هذه الصفحة
عندما لا تنتقل ذاكرة الذكاء الاصطناعي معك بين الأدوات
 عمار نجار
 صورة منشأة بالذكاء الاصطناعي
أستخدم عدة أدوات للذكاء الاصطناعي بانتظام، لكل منها دور مختلف. يساعدني ChatGPT على تطوير الأفكار وكتابة المقالات ومراجعة النصوص والتأمل في التجارب. أما Claude Code، فأعتمد عليه في جزء كبير من عملي التقني، بدءاً من تحليل المشكلات والتخطيط للتنفيذ، وصولاً إلى مراجعة القرارات المعمارية للبرمجيات. وأستخدم أيضاً نماذج ذكاء اصطناعي محلية لمعالجة المحتوى الشخصي الذي أفضّل إبقاءه على جهازي.
مع تزايد اعتمادي على هذه الأدوات في عملي اليومي، بدأت ألاحظ مشكلة متكررة. فكل أداة تتعرف مع الوقت على جوانب معينة من عملي وتفضيلاتي ونقاشاتي السابقة، لكن هذه المعرفة تبقى غالباً محصورة داخل الأداة نفسها. فقد أمضي وقتاً طويلاً في مناقشة موضوع مع أحد المساعدين، ثم أجد نفسي مضطراً إلى شرح الخلفية نفسها لمساعد آخر.
كنت قد واجهت تحدياً مشابهاً أثناء تنظيم خزنتي في Obsidian، التي نمت لتضم أكثر من 1,000 ملاحظة. وفي مقال الحفاظ على فائدة المعرفة، تناولت كيف يؤثر تنظيم المعلومات وإمكانية العثور عليها في مدى فائدتها مع مرور الوقت. وقد أثّرت تلك التجربة في الطريقة التي بدأت أنظر بها إلى المعرفة المتراكمة داخل أدوات الذكاء الاصطناعي المختلفة.
ما الذي يمكن توقعه من ذاكرة الذكاء الاصطناعي
تشكّلت توقعاتي من ذاكرة الذكاء الاصطناعي من خلال الاستخدام العملي لهذه الأدوات. فعندما أعود إلى موضوع سبق أن ناقشته، أتوقع أن يكون المساعد على دراية بالخلفية ذات الصلة، وأن يراعي التفضيلات التي حددتها سابقاً، ويأخذ القرارات والملاحظات السابقة في الحسبان.
أدركت تدريجياً أن هناك عدة آليات تسهم فيما نعتبره ذاكرة للمساعد. فسجل المحادثات يحتفظ بالنقاشات السابقة، لكن محتواها لا يكون بالضرورة متاحاً في جلسة جديدة. ويمكن للذاكرة الدائمة الاحتفاظ بمعلومات مختارة عبر محادثات متعددة، بينما يحدد السياق الحالي المعلومات التي يستطيع النموذج استخدامها أثناء التفاعل. وتعتمد الأدوات التقنية أيضاً على ملفات المشاريع والتعليمات والتوثيق للاحتفاظ بالمعلومات بين الجلسات.
وتختلف المدة التي تبقى فيها المعلومات مفيدة بحسب طبيعتها. فقد تظل تفضيلاتي في الكتابة مهمة لأشهر، بينما تتغير تفاصيل التنفيذ البرمجي باستمرار. وقد يبقى قرار معماري مؤثراً طوال مدة المشروع، في حين لا تستعيد ملاحظة شخصية أهميتها إلا عندما أواجه موقفاً مشابهاً.
أدوات مختلفة ومعلومات مختلفة
تعرف ChatGPT من خلال محادثاتنا على جوانب عديدة من خلفيتي المهنية واهتماماتي. أما Claude Code، فيكتسب نوعاً مختلفاً من المعرفة أثناء العمل على مستودعات الشيفرة البرمجية، وتحليل المشكلات التقنية، ومتابعة قرارات التنفيذ.
وتعتمد نماذجي المحلية على السياق والملفات التي أتيحها لها. أستخدمها في معظم المهام الشخصية، مثل التأمل في التجارب، والتخطيط لشؤون الأسرة والمنزل، ومتابعة الصحة والعادات، واستكشاف الاهتمامات الشخصية، ومعالجة المستندات الحساسة التي أريد الاحتفاظ بها على جهازي. وتناولت تفاصيل هذا الإعداد في مقال إعداد الذكاء الاصطناعي المحلي بعد ستة أشهر.
يناسب هذا التقسيم طبيعة عملي، وأجد في تخصص كل أداة فائدة واضحة. لكن الموضوعات لا تبقى دائماً ضمن حدود أداة واحدة. فقد تؤثر مناقشة معمارية في عمل تنفيذي لاحق، وقد تتحول تجربة تقنية إلى مادة لمقال أو تأمل في تجربة قيادية.
وعندما ينتقل الموضوع من أداة إلى أخرى، لا تنتقل معه المعلومات التي جرى تطويرها سابقاً بصورة تلقائية. لذلك أحتاج إلى تحديد ما هو مهم منها وإتاحته للمساعد الذي سأتابع العمل معه.
كيف استفدت من ذاكرة الذكاء الاصطناعي؟
من الأمثلة المفيدة قدرتي على مطالبة ChatGPT بالرجوع إلى نقاشات سابقة حول موضوع معين. فعندما أكون قد طوَّرت فكرة عبر عدة محادثات، أستطيع أحياناً طلب ملخص للملاحظات والقرارات والاستنتاجات التي توصلنا إليها. ويمنحني ذلك نقطة انطلاق جيدة لمواصلة العمل.
ومن الاستخدامات المفيدة أيضاً طلب توصيات تراعي ملفي الشخصي. يستطيع ChatGPT في كثير من الأحيان الاستفادة من خلفيتي المهنية ومسؤولياتي واهتماماتي، فتكون الإجابات أقرب إلى ظروفي الفعلية، من دون الحاجة إلى شرحها من البداية في كل مرة.
أظهرت لي هذه التجارب مدى فائدة المعلومات التي يحتفظ بها المساعد. لكن النتائج كانت أكثر موثوقية عندما طلبت من ChatGPT صراحةً الاستفادة من معلومات سابقة، خصوصاً عندما كنت أعرف مسبقاً أي خلفية يحتاج إليها. وكان ذلك مفيداً في البحث الموجّه والتأمل في التجارب، بينما كانت النتائج أقل قابلية للتوقع عندما انتظرت أن يستحضر المساعد المعلومات المهمة من تلقاء نفسه.
أين لم تتحقق توقعاتي؟
أصبحت عدم الموثوقية أكثر وضوحاً في موقفين: عندما لم أطلب السياق السابق، وعندما كان السياق المناسب موجوداً داخل محادثة بدلاً من ملف منفصل.
بدون تحريض صريح، قد يفهم ChatGPT الموقف المهني العام ويتجاهل تفاصيل من نقاشات سابقة كان من شأنها تغيير طريقة صياغة التوصية. قد تظل النتيجة مفيدة، لكنها تتطلب توضيحات إضافية. من المستحيل توقع المحادثات السابقة التي قد تكون ذات صلة، ولا توجد طريقة للتحقق مما حفظه المساعد في ذاكرته.
يطرح Claude Code صعوبة ذات صلة في سياق مختلف. أثناء مهمة تقنية شاملة، أعتمد على التحليل والنقاش لتطوير سياق مهم. تُحدد القيود، وتُقيَّم البدائل، وتُتخذ القرارات، ويتطور فهم المشكلة تدريجياً.
يتحول جزء من هذه المعلومات إلى الشيفرة البرمجية أو التوثيق. بينما تبقى تفاصيل أخرى في المحادثة، وخصوصاً الأسباب الكامنة وراء القرارات والبدائل التي نوقشت. بدء جلسة جديدة دون استعادة السياق المناسب يعني أنني يجب أن أعيد بناء جزء من ذلك التفكير. يوفر Claude Code وسائل لاستئناف الجلسات والحفاظ على تعليمات المشاريع، لكن سير العمل لا يقدم المعلومات المطلوبة دائماً في الوقت المناسب.
لا تمثل طريقة الفشل عيباً في الأدوات. من مسؤوليتي تحديد المعلومات ذات الصلة واختيارها وإتاحتها. ذلك ينجح عندما يكون نطاق المهمة ضيقاً والمواد الواضحة. لكنه يفشل عندما تغطي المحادثة موضوعات متعددة، أو عندما نوقش ما أحتاج إليه قبل أسابيع ولم يُحفظ خارج المحادثة.
استخدام Obsidian مصدراً مشتركاً للمعرفة
كنت أحتفظ بالفعل بمجموعة كبيرة من الملاحظات في Obsidian، تشمل المعرفة التقنية والقرارات والاجتماعات والكتب والتجارب المهنية. وبما أن كثيراً من هذه المعلومات كان منظماً ومترابطاً، بدا استخدامه لتوفير السياق لأدوات الذكاء الاصطناعي امتداداً طبيعياً للنظام الذي بنيته.
 صورة منشأة بالذكاء الاصطناعي
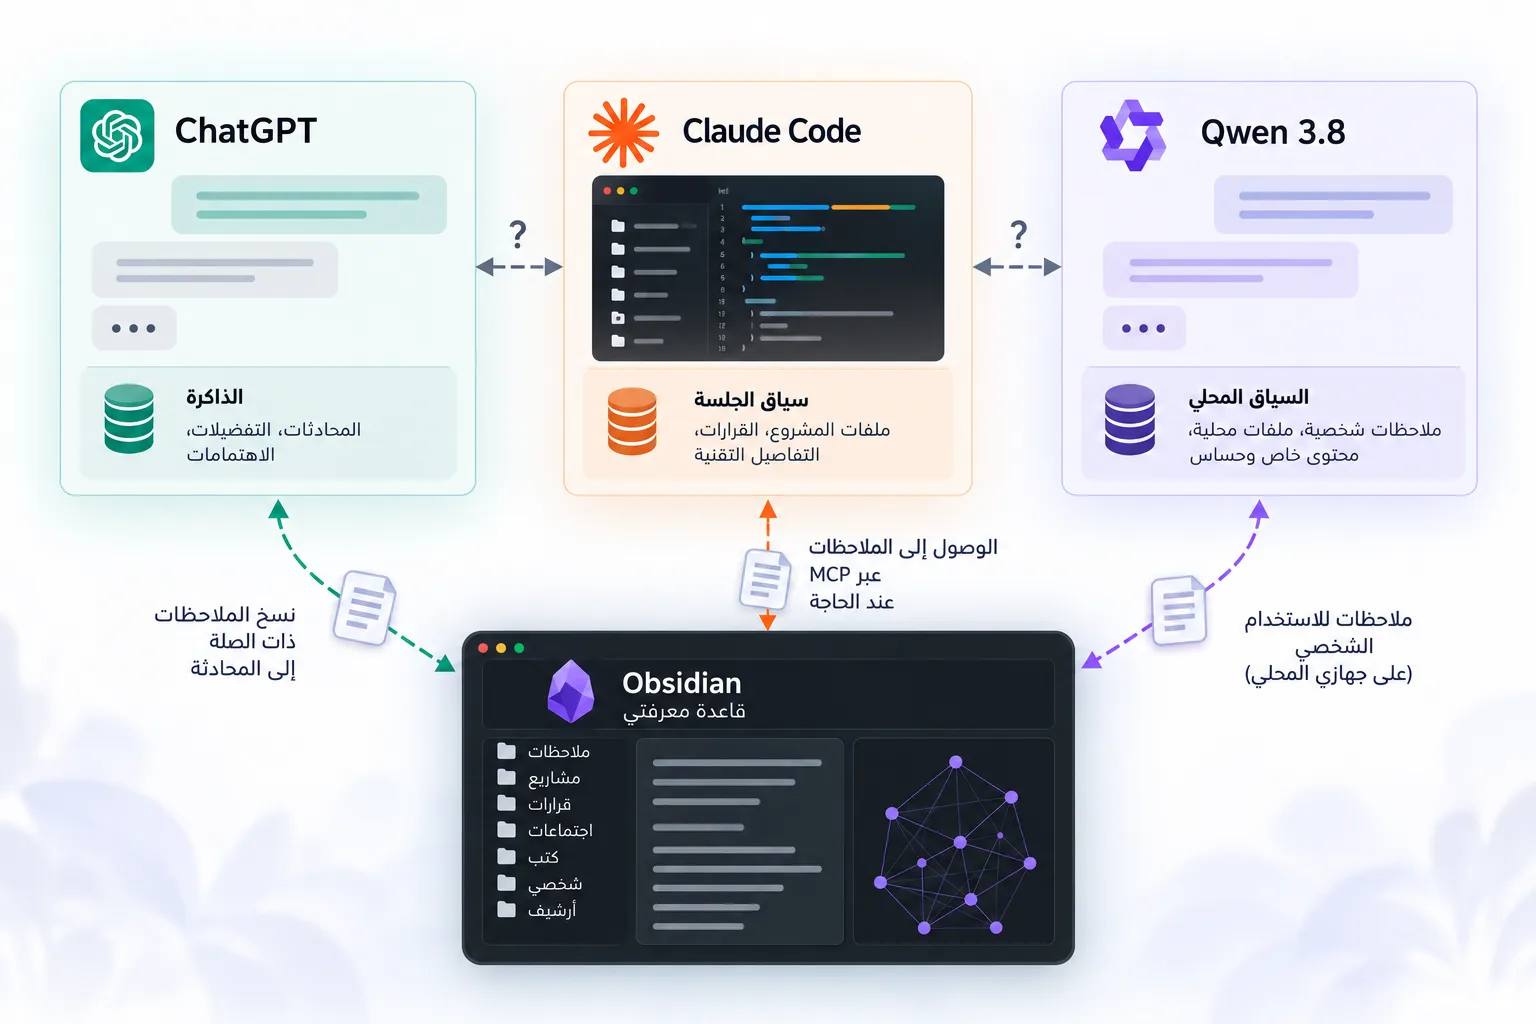
عند العمل مع ChatGPT، كنت أختار الملاحظات المناسبة من Obsidian وأنسخ محتواها إلى المحادثة. وبهذه الطريقة، أستطيع توفير المعلومات اللازمة مباشرةً، سواء أردت مراجعة قرار سابق، أو تطوير فكرة مستمدة من كتاب، أو التأمل في تجربة مررت بها.
أما مع Claude Code، فاستخدمت تكاملاً مع Obsidian عبر MCP، يتيح للمساعد قراءة الملاحظات وتحديثها. وبدلاً من نسخ المحتوى بنفسي، أصبح بإمكاني أن أطلب منه استرجاع ملاحظة محددة أو توثيق نتيجة نقاش. وعملياً، كنت أوجّه Claude Code إلى ملاحظات بعينها، بدلاً من أن أطلب منه استكشاف الخزنة بأكملها.
أفادني كلا الأسلوبين. فقد استطعت استخدام قاعدة المعرفة نفسها في بيئات مختلفة، مع الاحتفاظ بالتحكم في المعلومات التي أشاركها. وكان ذلك مهماً خصوصاً عندما تتطلب المهمة الاستفادة من معلومات شخصية، إذ أردت أن أقرر بنفسي ما يمكن إرساله إلى نموذج مستضاف لمعالجته. وقد أثّر هذا الفصل أيضاً في طريقة مشاركتي لملاحظات Obsidian. فبعض الملاحظات يمكن استخدامها مع المساعدين المستضافين، بينما أفضّل أن تبقى ملاحظات أخرى داخل بيئتي المحلية بالكامل.
مع ذلك، بقي عليّ أن أحدد بنفسي الملاحظات التي قد تفيد في المهمة الحالية، وأن أتأكد من إتاحتها للمساعد. وعندما تنتج عن محادثة ملاحظة مهمة أو قرار يستحق الاحتفاظ به، كان عليّ أيضاً أن أتذكر توثيقه. فقدرةُ Claude Code على التعامل المباشر مع الخزنة لا تعني أنه سيحدد تلقائياً كل ما ينبغي استرجاعه أو حفظه.
نجح هذا الأسلوب اليدوي عندما كنت أحرص على تنفيذ هذه الخطوات. لكن مع ازدياد عدد المحادثات والموضوعات، أصبح من الصعب الاستمرار في تطبيقه بانتظام. كنت أقدّر قدرتي على تحديد المعلومات التي يستطيع كل مساعد الوصول إليها، وفي الوقت نفسه أردت تقليل الوقت الذي أقضيه في إدارة هذا التبادل، حتى أتمكن من التركيز أكثر على العمل نفسه. هذه الصعوبة تحديداً هي ما سعى خطوي التالي إلى تخفيفه.
ما يحتاج إلى تحسين
المشكلة ليست في الأدوات نفسها، بل في طريقة توزيع المعلومات بينها. كل أداة تطور ذاكرتها الخاصة، لكن لا مكان مشترك لتخزين المعرفة التي يمكنني نقلها بينها. يجب أن أختار بنفسي، وأنسخ، وألصق الملاحظات في المحادثات، أو أوجه Claude Code إلى ملفات محددة حددتها مسبقاً.
يحتاج اثنان إلى تغيير. أولاً، نظام يستطيع استرجاع المعلومات ذات الصلة بشكل أكثر اتساقاً دون أن أعرف مسبقاً أي الملاحظات ذات الصلة قبل بدء محادثة. ثانياً، تقليل الجهد اليدوي لنقل السياق بين الأدوات مع الحفاظ على تحكم واضح فيما يمكن لكل مساعد الوصول إليه.
أين تفقدون السياق في أغلب الأحيان عند الانتقال بين أدوات الذكاء الاصطناعي؟ وإلى أي مدى تفضّلون تفويض إدارة هذا السياق إلى الأدوات نفسها؟
يهمني أن أعرف كيف توازنون بين الراحة والتحكم في هذا الصدد.