Auf dieser Seite
Wie ich die KI-Memory-Erfassung zuverlässiger gemacht habe
 Ammar Najjar
 KI-generiertes Bild
In Aufbau eines lokalen KI-Memory-Repositories habe ich beschrieben, wie ich mit einem Markdown-Repository eine dauerhafte Wissensbasis geschaffen habe, auf die KI-Agenten zugreifen können. Sie konnten Informationen daraus lesen und aktualisieren, und ich hatte einen zentralen Ort, um relevantes Wissen über mehrere Sitzungen hinweg aufzubewahren. Dieser Ansatz funktionierte, allerdings hing die Pflege der gespeicherten Informationen weiterhin davon ab, dass die Agenten während ihrer eigentlichen Aufgaben daran dachten, zusätzliche Schritte auszuführen.
Die Memory-Pflege von der Unterhaltung trennen
In meinem bisherigen Ansatz war der Agent für zwei Aufgaben gleichzeitig verantwortlich: die eigentliche Anfrage zu bearbeiten und den Wissensspeicher zu pflegen. Er musste während einer Unterhaltung erkennen, welche Informationen nützlich sein könnten, entscheiden, ob sie dauerhaft erhalten bleiben sollten, und das Repository entsprechend aktualisieren.
Wenn sich der Agent auf die unmittelbare Aufgabe konzentrierte, konnten relevante Informationen ungespeichert bleiben. Das Repository bot zwar einen dauerhaften Speicher, aber es gab keinen eigenständigen Prozess, der Gesprächsinhalte erfasste und anschließend auf ihren langfristigen Nutzen prüfte.
Im neuen Ansatz kann sich der Agent auf seine eigentliche Aufgabe konzentrieren. Toolspezifische Integrationen erfassen die von den jeweiligen KI-Tools bereitgestellten Gesprächsereignisse und übergeben sie an einen gemeinsamen Verarbeitungsablauf. Dieser wertet die Inhalte aus, erkennt Informationen, die erhalten bleiben sollten, und aktualisiert das Repository. Dadurch muss der Agent nicht mehr während der Unterhaltung selbst entscheiden, ob etwas für die spätere Verwendung gespeichert werden sollte.
So funktioniert der neue Memory-Ablauf
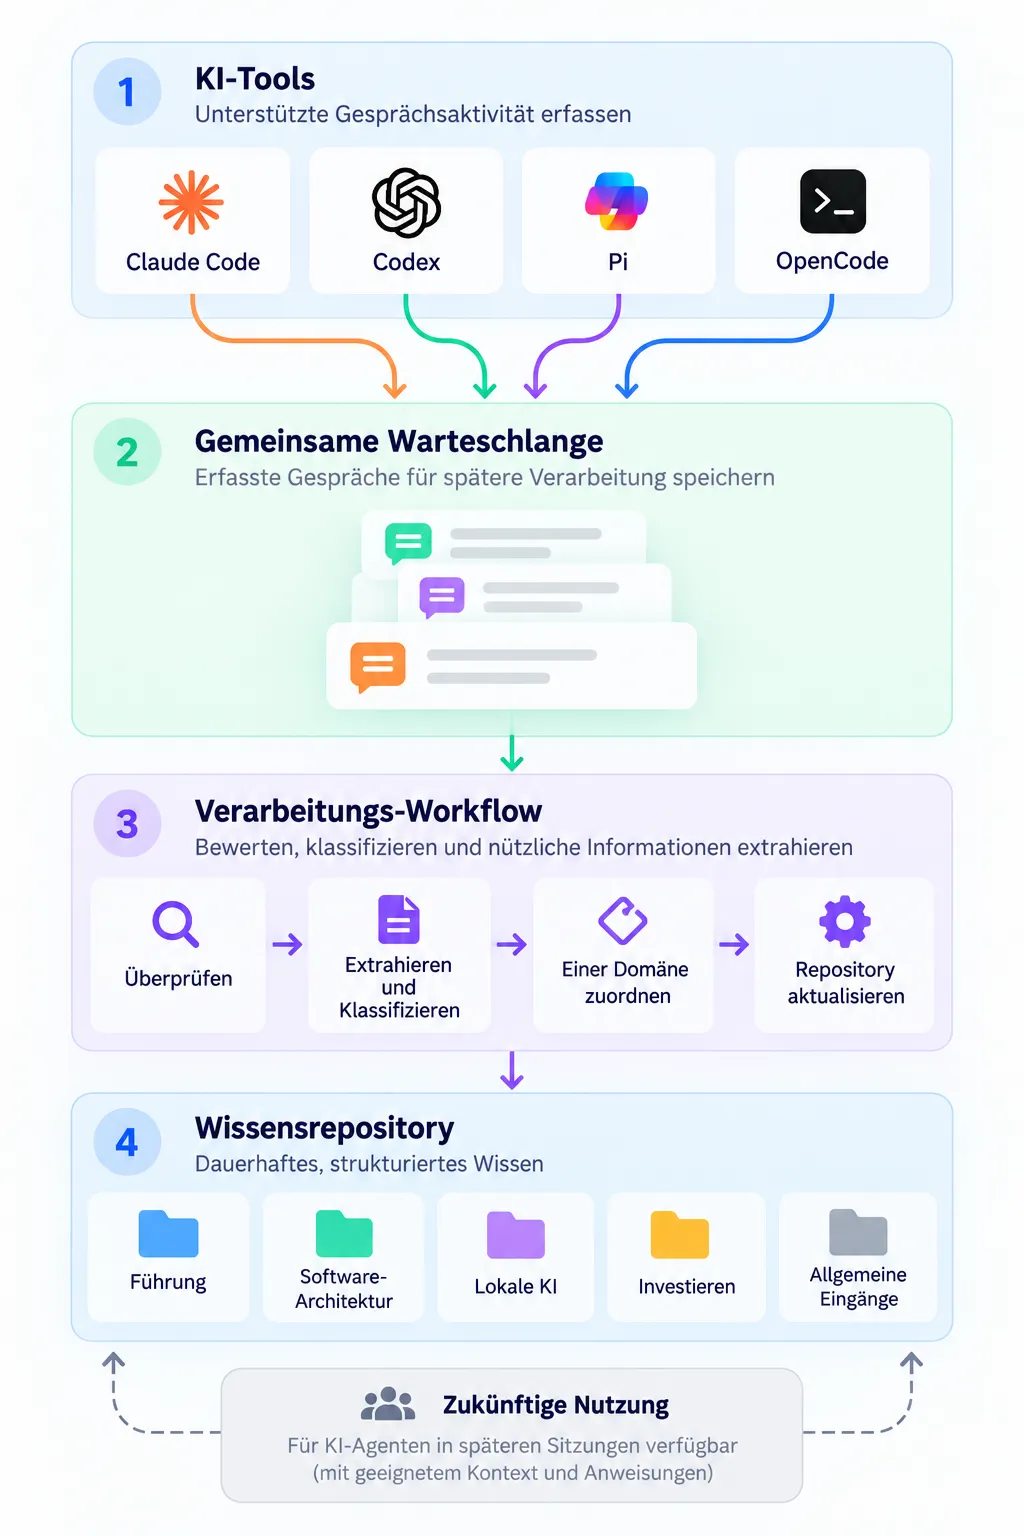
Die Architektur besteht aus vier Komponenten: Integrationen zur Erfassung von Gesprächsereignissen, einer gemeinsamen Warteschlange, einem Verarbeitungsprozess und dem dauerhaften Memory-Repository. Der Verarbeitungsprozess kann Informationen entweder einem bestimmten Wissensbereich zuordnen oder sie zur späteren Überprüfung in einem allgemeinen Posteingang ablegen.
 KI-generiertes Bild
Der Ablauf lässt sich anhand der Schritte im Diagramm nachvollziehen:
-
Eine Unterhaltung findet statt. Bei der Diskussion einer Architekturentscheidung oder einer Führungssituation können Beobachtungen, Abwägungen oder Schlussfolgerungen entstehen, die es wert sind, festgehalten zu werden.
-
Eine Integration erfasst unterstützte Gesprächsereignisse. Die Integrationen unterscheiden sich je nachdem, welche Ereignisse das jeweilige KI-Tool bereitstellt. Ihre gemeinsame Aufgabe besteht darin, diese Ereignisse zu erfassen und die Texte der Benutzeranfragen und Antworten des Assistenten an die Warteschlange zu übergeben. Die Integration entscheidet dabei nicht, welche Informationen langfristig nützlich sind.
-
Die gemeinsame Warteschlange hält die Inhalte vorübergehend bereit. Hier warten die erfassten Informationen auf ihre Verarbeitung. Gleichzeitig wird sichtbar, welche Einträge noch ausstehen. Der Ablauf ermöglicht es außerdem, ausgewählte Unterhaltungen von der Memory-Verarbeitung auszuschließen.
-
Ein separater Prozess wertet die gesammelten Inhalte aus. Unter normalen Bedingungen wird die Verarbeitung ausgelöst, sobald ein Gesprächsschritt abgeschlossen ist. Der Prozess nimmt die entsprechenden Einträge aus der Warteschlange und prüft, ob sie Beobachtungen, Entscheidungen, Erkenntnisse oder andere nützliche Informationen enthalten. Lassen sich diese einem bekannten Wissensbereich zuordnen, werden sie im Memory-Repository gespeichert. Andernfalls gelangen sie zur manuellen Überprüfung in einen allgemeinen Posteingang. Unterbrochene oder fehlgeschlagene Verarbeitungsschritte können erneut versucht oder zur Überprüfung markiert werden.
-
Das Memory-Repository erhält die aufbereiteten Informationen. Es bleibt die gemeinsame Quelle für dauerhaft gespeichertes Wissen, die ich bereits im vorherigen Artikel beschrieben habe. Ob ein Agent eine bestimmte Information in einer späteren Sitzung tatsächlich abruft, hängt weiterhin von seinem verfügbaren Kontext und seinen Anweisungen ab.
Warum ich mich für diese Architektur entschieden habe
Gesprächsinhalte zunächst zu erfassen und erst anschließend ihren langfristigen Nutzen zu bewerten, ermöglicht eine eigenständige Memory-Verarbeitung. Gleichzeitig bedeutet dieser Ansatz, dass vorübergehend auch Informationen gespeichert werden, die später wieder verworfen werden.
Das Repository und die Warteschlange befinden sich auf meinem Rechner. Daraus ergibt sich allerdings noch nicht, wo die erfassten Informationen verarbeitet werden. Der Verarbeitungsprozess übergibt den Gesprächskontext an das Kommandozeilen-Tool der KI-Anwendung, aus der die Unterhaltung stammt. Ob die Verarbeitung durch ein lokales Modell auf meinem Rechner oder durch ein gehostetes Modell erfolgt, hängt von der Konfiguration des jeweiligen Tools ab. Ich vermeide es, sensible Quelldaten im dauerhaften Memory-Repository abzulegen, und stelle sie bei Bedarf gezielt für einzelne Aufgaben bereit. Deshalb berücksichtige ich bei der Auswahl der Informationen für diesen Ablauf auch, wo sie verarbeitet werden.
Die verschiedenen KI-Tools unterscheiden sich darin, welche Funktionen und Gesprächsereignisse sie bereitstellen. Separate Integrationen ermöglichen es, diese Unterschiede bei der Erfassung zu berücksichtigen und die Informationen anschließend einheitlich weiterzuverarbeiten. Die Pflege mehrerer toolspezifischer Integrationen verursacht zusätzlichen Aufwand. Durch den gemeinsamen Verarbeitungsablauf können die Informationen aus unterschiedlichen Tools jedoch nach denselben Regeln behandelt werden.
Die Verarbeitung in einem separaten Prozess führt dazu, dass neue Informationen erst mit einer gewissen Verzögerung im dauerhaften Speicher verfügbar sind. Dafür bleibt die Verarbeitung von der eigentlichen Unterhaltung getrennt und lässt sich leichter nachvollziehen.
Was sich in der Praxis verändert hat
Wenn eine Integration unterstützte Gesprächsereignisse erfasst, muss der Agent diese nicht selbst zur Speicherung markieren. Er kann sich auf seine eigentliche Aufgabe konzentrieren. Welche Inhalte erfasst werden können, hängt von den Ereignissen ab, die das jeweilige Tool bereitstellt. Die erfassten Informationen gelangen anschließend in einen Verarbeitungsablauf, unabhängig davon, ob der Agent ihren Nutzen während der Unterhaltung erkannt hat.
Durch die Warteschlange und die Verarbeitungsprotokolle kann ich nachvollziehen, welche Informationen erfasst wurden, welche Einträge noch auf ihre Verarbeitung warten und welche Ergebnisse bereits vorliegen. Ich muss dafür nicht mehr frühere Unterhaltungen rekonstruieren. Stattdessen kann ich den aktuellen Zustand der Memory-Verarbeitung einsehen und erkennen, welche Vorgänge noch Aufmerksamkeit benötigen.
Auch die Verantwortlichkeiten innerhalb der Architektur sind klarer geworden. Die eigentliche Unterhaltung, die Erfassung der Gesprächsereignisse, ihre Verarbeitung und die dauerhafte Speicherung sind voneinander getrennt. Verschiedene KI-Tools können über ihre jeweiligen Integrationen Informationen beitragen, während die anschließende Verarbeitung einem gemeinsamen Ablauf folgt. Dadurch lässt sich die Architektur leichter verstehen und pflegen. Die einzelnen Integrationen können unabhängig voneinander weiterentwickelt werden und weiterhin denselben Verarbeitungsprozess nutzen.
Fazit
Durch die Trennung der Erfassung von der eigentlichen Arbeit des Agenten konnte ich die Pflege meines dauerhaften Wissensspeichers zuverlässiger und besser nachvollziehbar gestalten. Die nächste Herausforderung besteht darin, dafür zu sorgen, dass gespeichertes Wissen in zukünftigen Sitzungen dort verfügbar wird, wo es die weitere Arbeit unterstützen kann.
Wie viel automatische Erfassung von Gesprächsinhalten wäre für euch in Ordnung, und welche Arten von Unterhaltungen sollte ein solches System eurer Meinung nach speichern oder bewusst auslassen?