Auf dieser Seite
Mein lokales KI-Setup, sechs Monate später: 48 GB, Qwen3.8 und ein anderer Engpass
 Ammar Najjar
 KI-generiertes Bild
Vor einigen Monaten habe ich darüber geschrieben, wie ich auf einem MacBook Pro mit 16 GB Unified Memory ein brauchbares lokales KI-Setup für die Softwareentwicklung aufgebaut habe. Damals wurde fast jede Entscheidung durch den verfügbaren Arbeitsspeicher bestimmt. Ich experimentierte mit kleineren Modellen, begrenzte die Kontextgröße bewusst und suchte nach einer Kombination, die leistungsfähig genug für Entwicklungsaufgaben war und gleichzeitig genügend Ressourcen für IDE, Container, Browser und den Rest meiner Entwicklungsumgebung übrig ließ.
Seitdem bin ich auf einen Mac mit 48 GB Unified Memory umgestiegen. Ich hatte erwartet, dass mir der zusätzliche Speicher vor allem den Einsatz größerer Modelle ermöglichen würde. Das war auch der Fall. Nach einiger Zeit mit dem neuen Setup wurde jedoch eine interessantere Veränderung sichtbar: Ich optimierte plötzlich für ein anderes Problem.
Mit 16 GB stellte sich immer wieder die Frage, welches brauchbare Modell ich überhaupt auf dem Rechner ausführen konnte. Mit 48 GB denke ich darüber kaum noch nach. Viel wichtiger ist für mich inzwischen, ob das gesamte Setup über eine längere Coding-Session hinweg zuverlässig und sinnvoll nutzbar bleibt.
Der Zeitpunkt des Upgrades fiel außerdem mit mehreren Entwicklungen im lokalen KI-Ökosystem zusammen. Qwen3.8-27B wurde am 14. August 2026 veröffentlicht, und ich wechselte kurz darauf darauf. Im September ergänzte LM Studio dann die Unterstützung für Splash, eine Inference Engine, die für ausgewählte Modelle auf neuerer Apple-Silicon-Hardware optimiert ist.
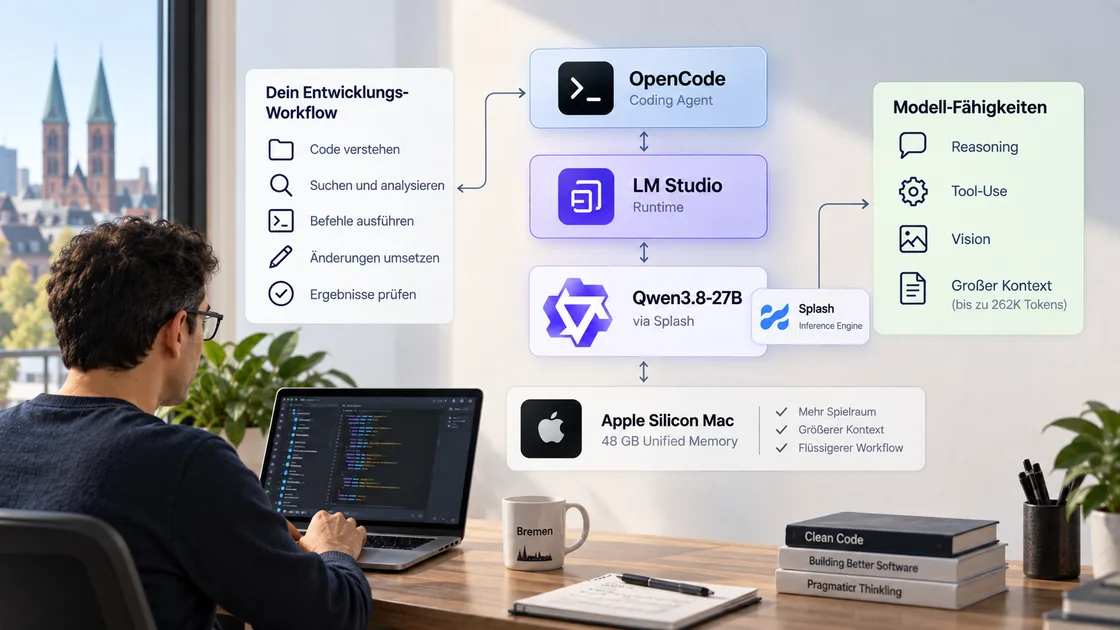
Stand September 2026 besteht mein lokales Setup damit aus OpenCode, LM Studio, Qwen3.8-27B und Splash. Noch interessanter ist für mich allerdings, dass sich dadurch verschoben hat, an welchen Stellen ich die Grenzen des Setups überhaupt noch wahrnehme.
Von kleineren Modellen zu einem Standardmodell
Eine Erkenntnis aus meinen früheren Experimenten gilt weiterhin: Die Größe eines Modells allein sagt erstaunlich wenig darüber aus, wie brauchbar ein lokales KI-Setup tatsächlich ist.
Das Modell muss sich den verfügbaren Speicher mit seinem Kontext, der Inference Runtime, dem Coding Agent und allen anderen Anwendungen auf dem Rechner teilen. Mit 16 GB waren kleinere Modelle deshalb oft die sinnvollere Wahl, selbst wenn ein größeres Modell auf dem Papier deutlich attraktiver aussah. Sie ließen genügend Ressourcen übrig, damit der gesamte Workflow praktikabel blieb.
Mit 48 GB hat sich diese Grenze so weit verschoben, dass ein 27B-Modell für den täglichen Einsatz realistisch geworden ist.
Als Qwen3.8-27B im August 2026 erschien, wechselte ich relativ schnell darauf. Die wichtigste Veränderung bestand für mich nicht einfach darin, ein größeres Modell nutzen zu können. Mit der Zeit hörte ich weitgehend damit auf, für unterschiedliche Aufgaben über unterschiedliche Modelle nachzudenken.
Heute verwende ich dasselbe Modell für die Exploration eines Repositories, Architekturdiskussionen, Tool Calls, Implementierungsaufgaben und konkrete Codeänderungen. Kleinere Modelle stehen weiterhin zur Verfügung, aber die frühere gedankliche Trennung zwischen einem schnellen Modell für einfache Aufgaben und einem stärkeren Modell für anspruchsvollere Arbeit spielt in meinem Alltag kaum noch eine Rolle.
Diese Vereinfachung hat sich als wertvoller erwiesen, als ich zunächst erwartet hatte.
Mein grundlegendes Setup wurde dadurch recht übersichtlich:
OpenCode
    ↓
LM Studio
    ↓
Qwen3.8-27B
Qwen3.8-27B ist ein dichtes Vision-Language-Modell mit 27 Milliarden Parametern sowie Fähigkeiten für Reasoning und Tool Use. Das native Kontextfenster umfasst 262.144 Tokens und bietet damit deutlich mehr Kapazität, als ich derzeit normalerweise verwende.
LM Studio bleibt aus ähnlichen Gründen wie bei meinem ursprünglichen Setup meine Runtime. Ich kann sehen, welches Modell geladen ist, die verfügbare Kontextgröße festlegen, das Modell über eine OpenAI-kompatible API bereitstellen und die Inference-Schicht vom Coding Agent getrennt halten. OpenCode übernimmt den Entwicklungsworkflow, während LM Studio für das Modell zuständig ist. Dadurch kann ich auf beiden Seiten relativ unkompliziert experimentieren.
Dieses Setup funktionierte für mich bereits gut. Dann veränderte Splash noch einmal die Performance-Seite.
Splash machte dasselbe Modell praktischer
LM Studio kündigte die Unterstützung für Splash am 18. September 2026 an. Einen Tag später, am 19. September, folgte LM Studio 0.4.25.
Splash ist eine von Inco AI entwickelte Open-Source-Inference-Engine, die für eine kleine Auswahl von Modellen auf Apple Silicon optimiert ist. Der Ansatz ist bewusst modellspezifisch. GPU-Kernels und Speicherplanung werden auf das jeweilige unterstützte Modell zugeschnitten, anstatt eine allgemeine Runtime für möglichst viele unterschiedliche Architekturen bereitzustellen.
Für Qwen3.8-27B enthält das Splash-Paket außerdem ein eigenes DFlash-2-Draft-Modell für Speculative Decoding. Das Paket verwendet eine 4-Bit-Version von Qwen3.8-27B und umfasst beim Download etwa 17,4 GB.
Die Hardwareanforderungen passen ziemlich genau zu meinem neuen Rechner. Splash benötigt mindestens 36 GB Unified Memory, empfohlen werden 48 GB oder mehr.
Mein aktuelles Modell ist deshalb:
incoai/Qwen3.8-27B-Splashund läuft über das Splash-Backend in LM Studio.
Die von Inco veröffentlichten Messwerte geben einen Eindruck davon, welchen Unterschied diese Optimierung machen kann. Auf einem M5 Pro mit 16-Core-GPU und 48 GB Unified Memory wurden bei kurzen Prompts ungefähr 74 Tokens pro Sekunde gemessen. Das sind Hersteller-Benchmarks und keine Werte, die ich selbst reproduziert habe. Für meinen Alltag ist ohnehin eine andere Beobachtung wichtiger.
Das Modell ist schnell genug, dass ich es während meiner normalen Entwicklungsarbeit dauerhaft als Standardmodell verwenden kann.
Gerade bei Coding Agents macht das einen Unterschied. Bei einer einzelnen Antwort fällt eine etwas längere Wartezeit möglicherweise kaum ins Gewicht. Ein Agent kehrt jedoch nach dem Lesen von Dateien, der Suche im Repository, dem Ausführen von Befehlen, Codeänderungen und der Überprüfung der Ergebnisse immer wieder zum Modell zurück. Die Latenz summiert sich dadurch über den gesamten Workflow.
Als diese Wartezeit weniger auffällig wurde, rückte eine andere Grenze stärker in den Vordergrund.
32K fühlten sich langsam zu klein an
In meinem ursprünglichen Setup erschienen mir 32K Kontext als vernünftiger Ausgangspunkt. Auf einem Rechner mit 16 GB war auch der Kontext eine Ressource, die ich gegen das Modell und den Rest der lokalen Entwicklungsumgebung abwägen musste.
Mit dem neuen Setup brachten mich längere OpenCode-Sessions dazu, diese Entscheidung noch einmal zu überdenken.
Eine Agent-Session sammelt erheblich mehr Informationen an als nur den ursprünglichen Prompt. OpenCode durchsucht das Repository, liest Dateien, erhält Ausgaben von Befehlen, verwendet Tools, verändert Code und trägt frühere Entscheidungen weiter. Eine zunächst kleine Aufgabe kann deshalb im Laufe der Bearbeitung eine beträchtliche Arbeitshistorie aufbauen, während der Agent ein immer genaueres Verständnis des Codes und der Aufgabe entwickelt.
Irgendwann nähert sich diese Historie der Kontextgrenze und muss komprimiert werden.
Compaction ist ein notwendiger Bestandteil längerer Agent-Sessions. Bei 32K begann ich allerdings, diesen Vorgang zu häufig wahrzunehmen. Der Agent konnte weiterarbeiten, aber Teile der bisherigen Arbeitshistorie mussten zusammengefasst werden, obwohl sich die Aufgabe noch weiterentwickelte. Bei längeren Sessions konnte sich dieser Zyklus mehrmals wiederholen.
An diesem Punkt begann ich, Kontext weniger als technische Eigenschaft des Modells und mehr als verfügbaren Arbeitsraum für den Agent zu betrachten.
Warum ich derzeit 64K verwende
Mein aktueller Standardwert liegt bei 65.536 Tokens:
Model:    Qwen3.8-27B Splash
Runtime:  LM Studio 0.4.25
Context:  65,536
Thinking: Enabled when useful
Client:   OpenCode
Die Entscheidung für 64K ist bewusst pragmatisch. Sie basiert weder auf einem Benchmark noch halte ich diesen Wert grundsätzlich für optimal.
Für meine typischen OpenCode-Sessions bedeutet er schlicht mehr Spielraum, bevor Compaction spürbar wird.
Qwen3.8-27B unterstützt nativ ein Kontextfenster von 262.144 Tokens, sodass ich problemlos deutlich mehr konfigurieren könnte. Derzeit sehe ich wenig Grund, diesen Wert standardmäßig auszureizen. Die meisten meiner Sessions benötigen keine Hunderttausende Tokens an Historie, und die Verarbeitung eines immer größeren aktiven Kontexts verursacht ihrerseits Kosten.
Für größere Aufgaben kann ich das Limit erhöhen. Für meine normale Entwicklungsarbeit bieten 64K bislang genügend Spielraum, ohne das gesamte Setup auf eine Kapazität auszulegen, die ich nur selten benötige.
Entscheidend ist für mich inzwischen, wie ich diesen Wert auswähle. Vor sechs Monaten wurde die Kontextgröße weitgehend davon bestimmt, was der Rechner verkraften konnte. Heute gehe ich von der Art der Agent-Session aus, die ich durchführen möchte, und gebe ihr genügend Arbeitsraum.
Die Grenze verschiebt sich weiter
Wenn ich beide Setups miteinander vergleiche, finde ich diese Entwicklung interessanter als die einzelnen Modelle.
Auf dem Rechner mit 16 GB war der verfügbare Speicher die dominierende Einschränkung. Dadurch landete ich bei kleineren Modellen und relativ konservativen Kontextgrößen.
Der Wechsel auf 48 GB machte Qwen3.8-27B als Standardmodell praktikabel. Dadurch musste ich je nach Aufgabe seltener zwischen verschiedenen Modellen wechseln. Splash verbesserte anschließend die Inference-Performance so weit, dass die Wartezeit auf ein lokales 27B-Modell während der Arbeit mit einem Agent weniger auffällig wurde.
Als diese Probleme kleiner wurden, fiel mir der Kontext stärker auf.
Diese Entwicklung hat auch verändert, was ich unter einem guten lokalen Modell verstehe. Das Modell ist nur ein Teil der Erfahrung. Bei Entwicklungsaufgaben interessiert mich, wie schnell der Agent iterieren kann, wie viel von seinem aufgebauten Verständnis während einer Aufgabe erhalten bleibt und ob das gesamte Setup parallel zu den Werkzeugen laufen kann, die ich ohnehin den ganzen Tag verwende.
Damit wird für mich zunehmend der vollständige Agent-Workflow zur sinnvolleren Einheit für Optimierungen.
Mein Setup im September 2026
Aktuell sieht mein Setup so aus:
 KI-generiertes Bild
| Komponente | Aktuelle Wahl |
|---|---|
| Rechner | Apple Silicon Mac, 48 GB Unified Memory |
| Agent | OpenCode |
| Runtime | LM Studio 0.4.25 |
| LM-Studio-Release | 19. September 2026 |
| Inference Engine | Splash |
| Modell | Qwen3.8-27B Splash |
| Qwen3.8-27B-Release | 14. August 2026 |
| Kontext | 65.536 Tokens |
| Nativer Modellkontext | 262.144 Tokens |
| Thinking | Bei Bedarf aktiviert |
| API | OpenAI-kompatibler Endpoint von LM Studio |
Die genauen Versionsnummern und Daten festzuhalten, erscheint mir diesmal besonders sinnvoll. Lokale KI entwickelt sich so schnell, dass ein heute beschriebenes Setup schon wenige Monate später deutlich anders aussehen kann. Dieser Artikel ist deshalb eine Momentaufnahme dessen, was für mich im September 2026 funktioniert, und keine Konfiguration, von der ich erwarte, dass sie unverändert bleibt.
Vor sechs Monaten ging es bei meinen Experimenten vor allem darum, genügend Modellleistung auf einem Rechner mit begrenztem Speicher unterzubringen. Heute habe ich genug Speicher, um ein leistungsfähiges 27B-Modell als Standard einzusetzen, und Splash macht die wiederholte Nutzung dieses Modells innerhalb eines Agent-Workflows deutlich angenehmer.
Damit beschäftigt mich inzwischen eine andere Frage. Ich denke weniger darüber nach, wie viel Modell ich auf dem Rechner unterbringen kann, und beobachte stärker, wie viel sinnvolle Arbeit das gesamte System leisten kann, bevor die nächste Grenze sichtbar wird.
Im Moment sind 64K Kontext Teil dieses Gleichgewichts. Ich gehe davon aus, dass es sich wieder verschieben wird.
Welche Grenze prägt dein Setup derzeit am stärksten? Falls du Modelle lokal betreibst, würde mich interessieren, wo du die Grenzen spürst: bei der Modellgröße, der Inference-Geschwindigkeit, dem Kontext oder ganz woanders. Schreib es mir in die Kommentare.