في هذه الصفحة
إعداد الذكاء الاصطناعي المحلي لدي بعد ستة أشهر: 48 GB وQwen3.8 وعنق زجاجة مختلف
 عمار نجار
 صورة منشأة بالذكاء الاصطناعي
قبل بضعة أشهر، كتبت عن تجربتي في بناء إعداد عملي للذكاء الاصطناعي المحلي لتطوير البرمجيات على MacBook Pro بذاكرة موحدة تبلغ 16 GB. في ذلك الوقت، كانت الذاكرة تؤثر في معظم قراراتي. جربت نماذج أصغر، وكنت حريصاً في تحديد حجم الـ Context، وبحثت عن تركيبة توفر قدرة جيدة على التعامل مع مهام البرمجة مع إبقاء مساحة كافية للـ IDE والـ Containers والمتصفح وبقية بيئة التطوير.
منذ ذلك الحين، انتقلت إلى جهاز Mac بذاكرة موحدة تبلغ 48 GB. توقعت أن تمنحني الذاكرة الإضافية إمكانية تشغيل نماذج أكبر بشكل أساسي، وهذا ما حدث بالفعل. لكن بعد استخدام الإعداد الجديد لفترة، لاحظت تغييراً أكثر أهمية: أصبحت أحاول تحسين جانب مختلف من التجربة.
مع 16 GB، كان السؤال المتكرر هو: ما النموذج العملي الذي يمكنني تشغيله على الجهاز؟ مع 48 GB، نادراً ما أفكر في هذا السؤال الآن. ما يهمني أكثر هو قدرة الإعداد بأكمله على البقاء عملياً وفعالاً خلال جلسة برمجة طويلة.
تزامن توقيت ترقية الجهاز أيضاً مع عدة تطورات في مجال الذكاء الاصطناعي المحلي. صدر Qwen3.8-27B في 14 أغسطس 2026، وانتقلت إليه بعد ذلك بوقت قصير. وفي سبتمبر، أضاف LM Studio دعم Splash، وهو محرك Inference محسّن لنماذج محددة على الأجيال الحديثة من Apple Silicon.
وحتى سبتمبر 2026، أصبح إعدادي المحلي بسيطاً نسبياً: OpenCode وLM Studio وQwen3.8-27B وSplash. والأهم بالنسبة لي أن هذه التغييرات نقلت الحدود التي أصبحت ألاحظها أثناء الاستخدام.
من النماذج الصغيرة إلى نموذج افتراضي واحد
ما زال أحد الدروس التي خرجت بها من تجاربي السابقة قائماً: حجم النموذج وحده لا يخبرنا بالكثير عن مدى فائدة إعداد محلي للذكاء الاصطناعي.
على النموذج أن يتشارك موارد الجهاز مع الـ Context ومحرك الـ Inference والـ Coding Agent وجميع البرامج الأخرى التي تعمل في الوقت نفسه. مع 16 GB، جعل ذلك النماذج الصغيرة خياراً منطقياً حتى عندما كانت النماذج الأكبر تبدو أكثر جاذبية على الورق. فقد كانت تترك موارد كافية ليبقى سير العمل بأكمله عملياً.
الانتقال إلى 48 GB غيّر هذه الحدود بما يكفي ليصبح استخدام نموذج بحجم 27B بشكل يومي خياراً واقعياً.
عندما صدر Qwen3.8-27B في أغسطس 2026، انتقلت إليه بسرعة نسبياً. التغيير الأهم بالنسبة لي لم يكن مجرد قدرتي على تشغيل نموذج أكبر. مع الوقت، توقفت إلى حد كبير عن التفكير في اختيار نموذج مختلف لكل نوع من المهام.
أستخدم الآن النموذج نفسه لاستكشاف الـ Repository، ومناقشة القرارات المعمارية، وتنفيذ Tool Calls، والعمل على مهام برمجية، وإجراء تغييرات فعلية على الكود. ما زالت النماذج الأصغر متاحة، لكنني لم أعد بحاجة إلى الفصل الذهني نفسه بين نموذج سريع للمهام البسيطة ونموذج أقوى للعمل الأكثر تعقيداً.
تبين أن هذا التبسيط أكثر فائدة مما توقعت.
أصبح إعدادي الأساسي كالتالي:
OpenCode
    ↓
LM Studio
    ↓
Qwen3.8-27B
Qwen3.8-27B هو نموذج Vision-Language كثيف يحتوي على 27 مليار Parameter، ويدعم Reasoning واستخدام الأدوات. كما يوفر Context Window أصلياً يصل إلى 262,144 Token، وهو أكبر بكثير مما أستخدمه عادة في الوقت الحالي.
ما زلت أستخدم LM Studio كـ Runtime للأسباب نفسها تقريباً التي ذكرتها في المقال السابق. أستطيع معرفة النموذج المحمّل، وتحديد حجم الـ Context، وإتاحة النموذج عبر API متوافق مع OpenAI، مع إبقاء طبقة الـ Inference منفصلة عن الـ Coding Agent. يتولى OpenCode سير العمل البرمجي، بينما يتولى LM Studio تشغيل النموذج، وهذا يجعل تجربة نماذج أو إعدادات مختلفة أمراً بسيطاً نسبياً.
كان هذا الإعداد يعمل بشكل جيد بالفعل. ثم جاء Splash وغيّر جانب الأداء مرة أخرى.
Splash جعل استخدام النموذج نفسه أكثر عملية
أعلن LM Studio عن دعم Splash في 18 سبتمبر 2026، وتبعه إصدار LM Studio 0.4.25 في 19 سبتمبر.
Splash هو محرك Inference مفتوح المصدر طورته Inco AI، ومحسّن لتشغيل مجموعة صغيرة من النماذج على Apple Silicon. يعتمد على تحسينات مخصصة لكل نموذج. يتم تصميم GPU Kernels وخطة إدارة الذاكرة بما يتناسب مع النموذج المدعوم، بدل الاعتماد على Runtime عام يستهدف عدداً كبيراً من المعماريات المختلفة.
بالنسبة إلى Qwen3.8-27B، تتضمن حزمة Splash أيضاً نموذج DFlash 2 مخصصاً لاستخدامه في Speculative Decoding. تستخدم الحزمة نسخة 4-bit من Qwen3.8-27B، ويبلغ حجم التنزيل نحو 17.4 GB.
متطلبات العتاد تتوافق بشكل جيد مع جهازي الجديد. يحتاج Splash إلى 36 GB على الأقل من الذاكرة الموحدة، بينما يُنصح باستخدام 48 GB أو أكثر.
لذلك أصبح النموذج الذي أستخدمه حالياً هو:
incoai/Qwen3.8-27B-Splashويعمل من خلال Splash backend داخل LM Studio.
تعطي الأرقام التي نشرتها Inco فكرة عن تأثير هذه التحسينات. على جهاز M5 Pro يحتوي على GPU بـ16 نواة و48 GB من الذاكرة الموحدة، سجلت الشركة نحو 74 Token في الثانية عند التعامل مع Prompts قصيرة. هذه أرقام Benchmark منشورة من الشركة وليست قياسات أعدت تنفيذها بنفسي، كما أن الملاحظة الأكثر أهمية بالنسبة لي ظهرت في الاستخدام اليومي.
أصبح النموذج سريعاً بما يكفي لأتركه كنموذجي الافتراضي أثناء العمل البرمجي المعتاد.
يصبح هذا الأمر مهماً بشكل خاص مع Coding Agents. قد لا يكون الانتظار قليلاً للحصول على إجابة واحدة مشكلة كبيرة، لكن الـ Agent يعود إلى النموذج باستمرار بعد قراءة الملفات، والبحث في الـ Repository، وتنفيذ الأوامر، وتعديل الكود، والتحقق من النتائج. لذلك تتراكم الـ Latency على امتداد سير العمل بالكامل.
وعندما أصبح هذا التأخير أقل وضوحاً، بدأت ألاحظ قيداً آخر بشكل أكبر.
بدأ 32K يبدو صغيراً
في إعدادي السابق، كان Context بحجم 32K نقطة بداية معقولة. على جهاز بذاكرة 16 GB، كان الـ Context مورداً آخر عليّ موازنته مع حجم النموذج وبقية بيئة التطوير المحلية.
مع الإعداد الجديد، دفعتني جلسات OpenCode الأطول إلى إعادة التفكير في هذا الاختيار.
تجمع جلسة الـ Agent معلومات أكثر بكثير من الـ Prompt الأولي. يبحث OpenCode داخل الـ Repository، ويقرأ الملفات، ويستقبل مخرجات الأوامر، ويستخدم الأدوات، ويعدل الكود، ويحمل القرارات السابقة معه أثناء العمل. لذلك يمكن لمهمة تبدأ بطلب صغير نسبياً أن تبني تاريخ عمل كبيراً بينما يطور الـ Agent فهمه للكود والمشكلة التي يعمل عليها.
في مرحلة ما، يقترب هذا التاريخ من حد الـ Context ويصبح من الضروري إجراء Compaction.
الـ Compaction جزء ضروري من جلسات الـ Agent الطويلة، لكنني بدأت ألاحظه أكثر مما أريد عند استخدام 32K. يستطيع الـ Agent مواصلة العمل، لكن أجزاء من تاريخ المهمة يجب تلخيصها بينما ما زال العمل يتطور. وفي الجلسات الأطول، قد تتكرر هذه الدورة عدة مرات.
عند هذه النقطة، بدأت أنظر إلى الـ Context باعتباره مساحة عمل متاحة للـ Agent أكثر من كونه مجرد خاصية تقنية للنموذج.
لماذا أستخدم 64K حالياً
القيمة الافتراضية التي أستخدمها حالياً هي 65,536 Token:
Model:    Qwen3.8-27B Splash
Runtime:  LM Studio 0.4.25
Context:  65,536
Thinking: Enabled when useful
Client:   OpenCode
اختيار 64K عملي بالدرجة الأولى. لا يعتمد على Benchmark، ولا أعتبره رقماً مثالياً يصلح للجميع.
هو ببساطة يمنح جلسات OpenCode التي أستخدمها عادة مساحة أكبر قبل أن يصبح الـ Compaction ملحوظاً.
يدعم Qwen3.8-27B Context Window أصلياً يصل إلى 262,144 Token، لذلك يمكنني إعداد قيمة أكبر بكثير. لكنني لا أرى حالياً سبباً لاستخدام هذا الحد كإعداد افتراضي. معظم جلساتي لا تحتاج إلى مئات الآلاف من الـ Tokens من التاريخ، كما أن معالجة Context نشط يزداد حجمه باستمرار لها تكلفتها أيضاً.
يمكنني رفع الحد للمهام الأكبر. أما في العمل البرمجي المعتاد، فقد منحني 64K حتى الآن مساحة كافية دون إعداد النظام بالكامل حول سعة نادراً ما أحتاج إليها.
التغيير المهم بالنسبة لي هو الطريقة التي أختار بها هذا الرقم. قبل ستة أشهر، كان حجم الـ Context يتحدد إلى حد كبير وفق ما يستطيع الجهاز تحمله. اليوم، أبدأ من نوع جلسة الـ Agent التي أريد تشغيلها، ثم أمنحها مساحة العمل التي تحتاج إليها.
الحدود تستمر في التحرك
عندما أقارن الإعدادين، أجد هذا التطور أكثر إثارة للاهتمام من النماذج نفسها.
على الجهاز ذي 16 GB، كانت الذاكرة هي القيد الأساسي. دفعني ذلك نحو نماذج أصغر وأحجام Context أكثر تحفظاً.
جعل الانتقال إلى 48 GB استخدام Qwen3.8-27B كنموذج افتراضي أمراً عملياً، وهذا قلل حاجتي إلى التبديل بين النماذج حسب المهمة. بعد ذلك، حسّن Splash أداء الـ Inference إلى درجة أصبح معها انتظار نموذج محلي بحجم 27B أقل حضوراً أثناء العمل مع الـ Agent.
وعندما أصبحت هذه المشكلات أقل وضوحاً، بدأ الـ Context يلفت انتباهي أكثر.
غيّر هذا التطور أيضاً ما أعنيه عندما أفكر في “نموذج محلي جيد”. النموذج ليس سوى جزء من التجربة. في العمل البرمجي، يهمني مدى سرعة الـ Agent في التكرار، ومقدار الفهم الذي يستطيع الاحتفاظ به مع تطور المهمة، وقدرة الإعداد بالكامل على العمل إلى جانب الأدوات التي أستخدمها أصلاً طوال اليوم.
لهذا أصبحت أرى سير عمل الـ Agent بأكمله كوحدة أكثر فائدة للتحسين.
إعدادي في سبتمبر 2026
هذا هو الإعداد الذي أستخدمه حالياً:
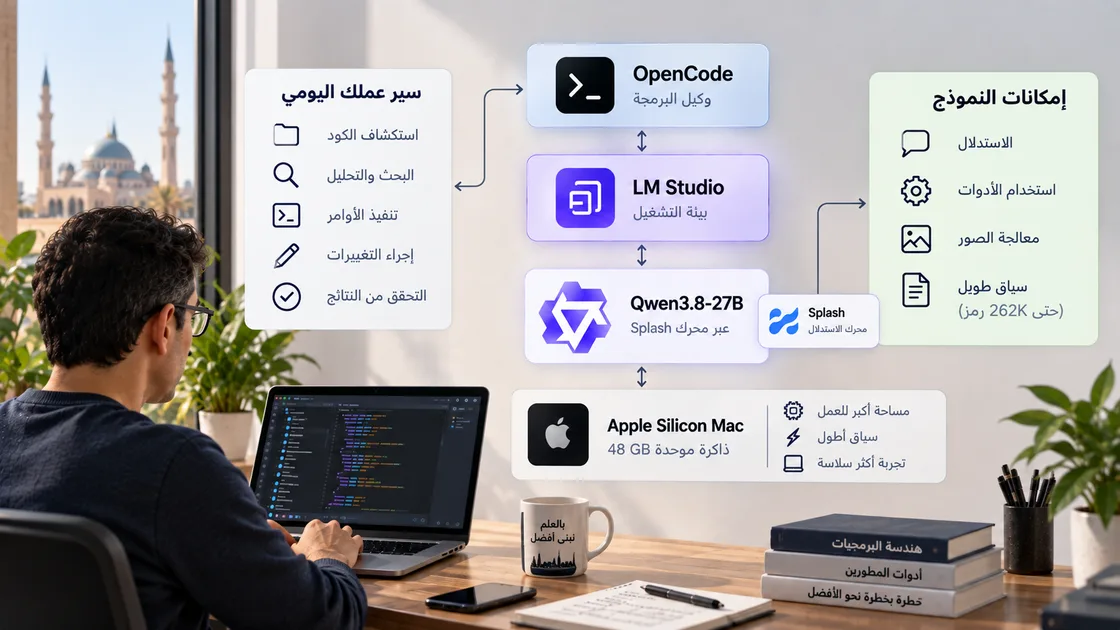 صورة منشأة بالذكاء الاصطناعي
| المكوّن | الإعداد الحالي |
|---|---|
| الجهاز | Apple Silicon Mac، بذاكرة موحدة 48 GB |
| Agent | OpenCode |
| Runtime | LM Studio 0.4.25 |
| تاريخ إصدار LM Studio | 19 سبتمبر 2026 |
| Inference Engine | Splash |
| النموذج | Qwen3.8-27B Splash |
| تاريخ إصدار Qwen3.8-27B | 14 أغسطس 2026 |
| Context | 65,536 Token |
| Native Context | 262,144 Token |
| Thinking | مفعّل عند الحاجة |
| API | OpenAI-compatible endpoint من LM Studio |
يبدو تسجيل أرقام الإصدارات والتواريخ أكثر أهمية بالنسبة لي هذه المرة، لأن مجال الذكاء الاصطناعي المحلي يتطور بسرعة تجعل إعداداً موصوفاً اليوم يبدو مختلفاً بعد بضعة أشهر فقط. لذلك تمثل هذه المقالة لقطة لما يعمل معي في سبتمبر 2026، وليست إعداداً أتوقع أن يبقى كما هو.
قبل ستة أشهر، كانت معظم تجاربي تدور حول الحصول على قدر كافٍ من قدرات النموذج ضمن جهاز محدود الذاكرة. اليوم، لدي ذاكرة كافية لاستخدام نموذج قوي بحجم 27B كنموذج افتراضي، وجعل Splash الاستخدام المتكرر لهذا النموذج داخل سير عمل الـ Agent أكثر سلاسة.
السؤال الذي يشغلني الآن مختلف. أقضي وقتاً أقل في التفكير في حجم النموذج الذي يمكنني تشغيله محلياً، وأراقب بشكل أكبر مقدار العمل المفيد الذي يستطيع النظام بأكمله إنجازه قبل أن يبدأ القيد التالي في الظهور.
في الوقت الحالي، يمثل Context بحجم 64K جزءاً من هذا التوازن. وأتوقع أن يتغير هذا التوازن مرة أخرى.
ما هو القيد الذي يؤثر في إعدادك حالياً؟ إذا كنت تشغّل النماذج محلياً، يهمني أن أعرف أين تشعر بالحدود: في حجم النموذج، أم سرعة الـ Inference، أم الـ Context، أم في جانب آخر تماماً؟ شاركني رأيك في التعليقات.